

这类舞蹈视频的动作迁移先要分清三件事:原片只提供舞蹈动作,人物由角色图约束,背景由场景图约束。生成结果中,原本画面里的橙色动物角色已经换成制服女生,场景也变为城市广场。
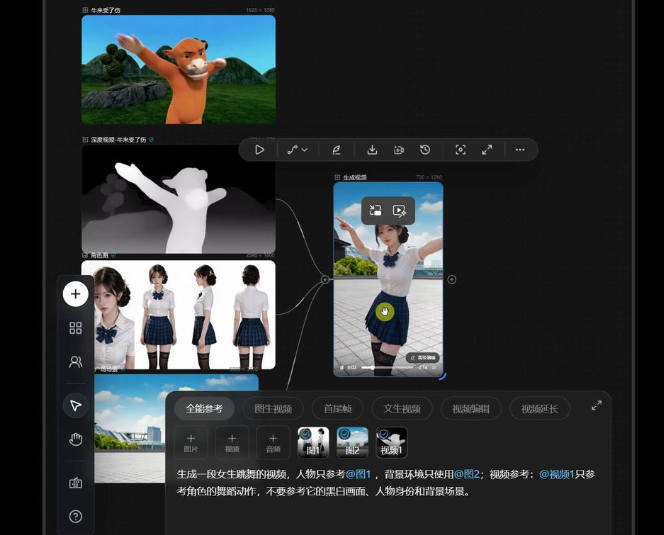
14秒结果节点已经出现,画面中的人物和环境分别对应角色图与场景图。
立即使用千鹿AI画布:【点击进入使用】;
邀请码:【9RZnMn】,立领100算力,体验更多功能噢
为什么结果能换掉原片的人物和背景?
生成节点没有让一份素材同时决定全部内容,而是通过提示词给三类参考分工:
| 参考内容 | 生成节点中的分工 | 提示词约束 |
|---|---|---|
| 深度视频 | 视频1,只参考角色的舞蹈动作 | 不参考黑白画面、人物身份和背景场景 |
| 人物四视图 | 图1,只参考人物 | 不承担背景和动作参考 |
| 城市广场图 | 图2,只用于背景环境 | 不承担人物身份和动作参考 |
这种写法把容易混在一起的动作、人物和环境拆开。出现偏差时,也能按分工检查对应参考是否写清楚。
先确认14秒动作参考已经就绪
起始节点标题为“牛来受了伤”,画面尺寸显示为1920×1080。其下方是“深度视频-牛来受了伤”节点;读取期间会显示“读取视频轨道中”,完成后才出现可播放结果。
深度视频节点显示1024×576、总长14秒,预览中保留了主体和环境的灰度层次。
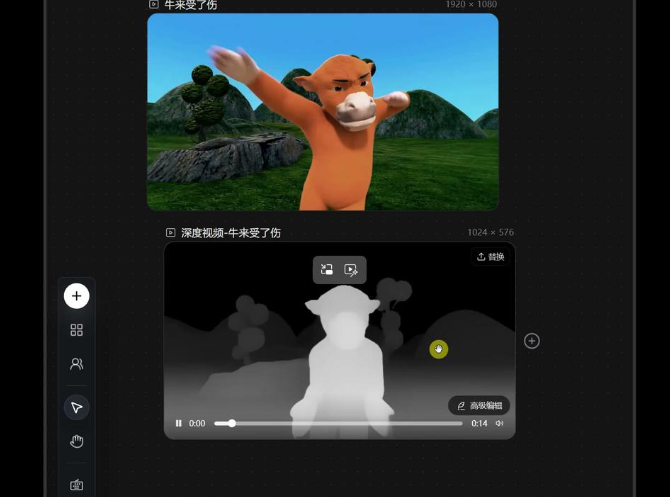
原始彩色视频位于上方,完成读取的黑白深度视频位于下方。
黑白预览不是目标成片的视觉风格。在这套设置中,它被指定为视频1,并且只负责提供舞蹈动作参考。
人物图和场景图各管一件事
角色节点包含人物近景以及正面、侧面、背面视图;场景节点则是一张城市广场图片。两者与深度视频分别存在,便于在生成面板中单独引用。
画布左侧同时保留人物四视图和城市广场图,两类素材的身份清楚分开。
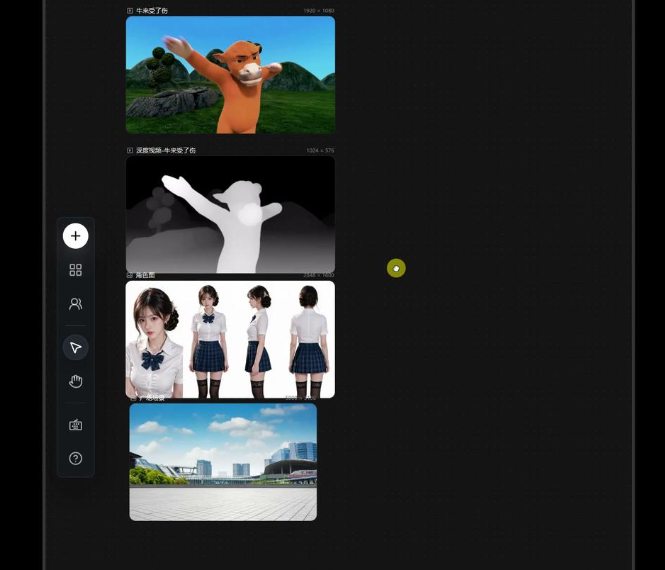
人物外观、舞蹈参考和背景环境分别保留在独立节点中。
准备生成时,角色图不负责场景,场景图也不负责动作。先把三类素材的用途分清,再核对提示词中的引用编号。
提示词主动排除原片身份
生成面板使用的提示词是:
生成一段女生跳舞的视频,人物只参考@图1,背景环境只使用@图2;视频参考:@视频1只参考角色的舞蹈动作,不要参考它的黑白画面、人物身份和背景场景。
这里最关键的不是“女生跳舞”几个字,而是后半句对参考范围的限制。图1锁定人物,图2限定环境,视频1只承接动作,同时排除原片的动物身份、黑白画面和山地背景。
生成面板中图1、图2和视频1均处于引用状态,右侧节点显示正在生成。
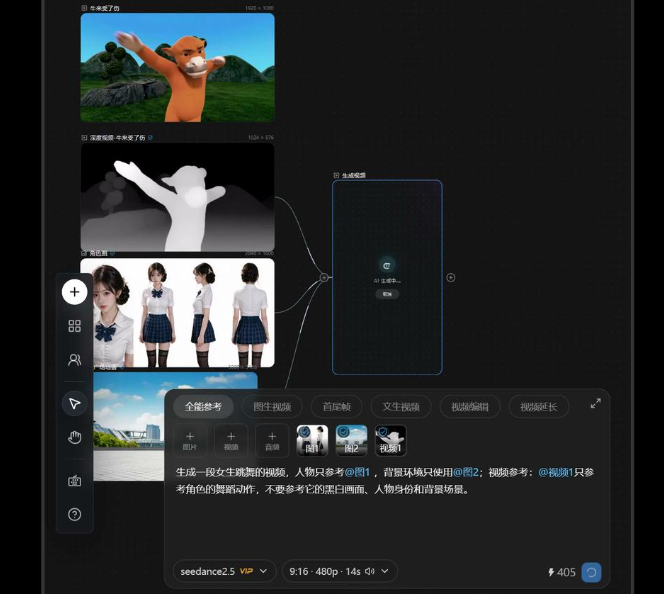
图1、图2和视频1已被提示词分别用于人物、背景和舞蹈动作。
底部参数栏显示Seedance2.5 VIP、9:16、480p和14秒。正式发起任务前,应再次核对引用编号,避免图1、图2与视频1错位。
如何验收
按当前画布关系,可以依次核对:
- 原始舞蹈片段与对应深度视频都已出现,深度视频能够播放14秒。
- 人物四视图与城市广场图分别位于独立节点。
- 生成面板引用图1、图2和视频1,并在提示词中写清各自职责。
- 参数保持9:16、480p和14秒,模型栏显示Seedance2.5 VIP。
- 生成节点完成后,打开14秒结果并从头播放。
如果生成后仍保留动物外形或山地背景,应先返回提示词和引用编号,检查人物、背景、动作三项是否发生混用。
完整播放时重点检查:
- 开头、中段和结尾的人物脸部、发型与服装是否一致;
- 手臂、手指、腿部和身体转向是否出现变形或跳变;
- 城市广场的地面、建筑和天空是否连续;
- 需要声音时,音轨是否存在且与画面相符。
关于补足深度视频复刻动作的基础操作,可以阅读: